あなたはプロフェッショナルなITスキルを向上させ、あなたのキャリアでいくつかの進歩や改善を望むなら、Databricks実際の試験に合格し、認定資格を取得するのがいい始めかもしれません。資格認定を受けることによって、他の人から目立つようになり、仕事に大きな違いが生まれます。Databricks Certified Associate Developer for Apache Spark 3.5 - Python exam pdfの難しさでほとんどの受験生は近年失敗しましたと知られます。だから、当社の認定専門家は、練習する時間があまりない受験生に最新かつ有効のDatabricks Certified Associate Developer for Apache Spark 3.5 - Python試験問題集を書いています。質問を勉強し、Databricks Certified Associate Developer for Apache Spark 3.5 - Python試験の回答を覚えておくには、1〜2日だけかかります。Associate-Developer-Apache-Spark-3.5 MogiExam pdfの準備中に疑問がある場合、私たちはあなたのそばにいます。 私たちの目的は、お客様がより少ない時間と費用で資格試験に合格するのを支援することです。

当社はどのようにDatabricks Certification本当の試験に合格することが保証できるか疑問がありますか。Databricks Certified Associate Developer for Apache Spark 3.5 - Python pdf試験問題集のメリットをお伝えします。まず、実際の質問と正確なAssociate-Developer-Apache-Spark-3.5試験の回答は、長年にわたり試験のトレーニング資料の研究に取り組んだIT専門家によって作成されています。最新のDatabricks Certified Associate Developer for Apache Spark 3.5 - Python試験問題集pdfに十分な注意を払うと、資格試験の成功は明確になります。次に、当社の職員は、Databricks Certified Associate Developer for Apache Spark 3.5 - Python試験問題集の正確性を保証するために試験問題のアップデートを常に確認しています。我々社の学習教材は現在の試験情報に基づいて更新され、Databricks Certified Associate Developer for Apache Spark 3.5 - Python問題集の1年間の無料アップデートは支払い後に許可されます。最後、Databricks Certified Associate Developer for Apache Spark 3.5 - Python MogiExam pdfのアップデートがあれば、すぐに最新のものをお届けします。あなたはメールボックスを確認するだけです。
あなたは顧客のフィードバックに基づいて当社Databricks Certified Associate Developer for Apache Spark 3.5 - Python試験問題集の合格率はほぼ89%であることがわかります。 返信されたお客様の多くは、Databricks実際の試験に新たな質問がわずかしかないと述べました。さらに、当社のテストエンジンは、Databricks Certified Associate Developer for Apache Spark 3.5 - Python 試験問題集を練習するときのテスト時間を設定できるように、あなたの準備をより簡単にします。
質問と回答の正確性をチェックしたくてDatabricks Certified Associate Developer for Apache Spark 3.5 - Python 試験問題集pdf版の無料デモをダウンロードします。当社のDatabricks Certified Associate Developer for Apache Spark 3.5 - Python試験問題集の答えはあなたが試験に合格することを保証しますが、我々社の試験勉強の資料で試験に失敗する場合は、全額返金を承諾します。Databricks Certified Associate Developer for Apache Spark 3.5 - Python試験問題集に関するご質問はお気軽にお問い合わせください。当社の職員は全日24時間であなたのお問い合わせを待っております。あなたの参加を楽しみにしています。
Databricks Certified Associate Developer for Apache Spark 3.5 - Python試験問題集をすぐにダウンロード:成功に支払ってから、我々のシステムは自動的にメールであなたの購入した商品をあなたのメールアドレスにお送りいたします。(12時間以内で届かないなら、我々を連絡してください。Note:ゴミ箱の検査を忘れないでください。)
Databricks Associate-Developer-Apache-Spark-3.5 試験シラバストピック:
| セクション | 比重 | 目標 |
|---|---|---|
| トピック 1: Apache SparkにおけるPandas APIの利用 | 5% | - 主な違いと制限事項 - Pandas構造とSpark構造の相互変換 - SparkにおけるPandas APIの概要 |
| トピック 2: Apache Sparkのアーキテクチャとコンポーネント | 20% | - 耐障害性とガベージコレクション - 実行階層と遅延評価 - Sparkアーキテクチャの概要 - 実行モードとデプロイモード - シャッフル、アクション、ブロードキャスト |
| トピック 3: Spark Connectを使用したアプリケーションのデプロイ | 5% | - リモートSparkクラスターへの接続 - Spark Connectのアーキテクチャ - Spark Connect経由でのアプリケーション実行 |
| トピック 4: Apache Spark DataFrame APIアプリケーションのトラブルシューティングとチューニング | 10% | - デバッグとログの取得 - パフォーマンス上のボトルネックの特定 - メモリとリソース使用量の管理 - 変換処理とアクションの最適化 |
| トピック 5: Spark SQLの利用 | 20% | - カタログおよびメタデータAPIの利用 - DataFrameとSpark SQLの連携 - 関数と式の操作 - SQLクエリの実行 |
| トピック 6: Apache Spark DataFrame APIを使用したアプリケーション開発 | 30% | - 各種形式でのデータの読み書き - データのフィルタリング、並べ替え、集計 - ユーザー定義関数(UDF) - データのパーティショニングとバケッティング - DataFrameの作成とスキーマの定義 - データセットの結合と統合 - 欠損値の処理とデータ品質の確保 - 列の選択、名前変更、変更 |
| トピック 7: Structured Streaming | 10% | - 出力モードとトリガー - ストリーミングの概念とアーキテクチャ - 耐障害性と状態管理 - ストリーミングクエリの定義 |
Databricks Certified Associate Developer for Apache Spark 3.5 - Python 認定 Associate-Developer-Apache-Spark-3.5 試験問題:
A data scientist wants each record in the DataFrame to contain:
The first attempt at the code does read the text files but each record contains a single line. This code is shown below: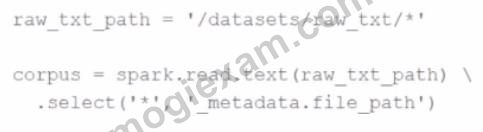
The entire contents of a file
The full file path
The issue: reading line-by-line rather than full text per file.
Code:
corpus = spark.read.text("/datasets/raw_txt/*") \
.select('*', '_metadata.file_path')
Which change will ensure one record per file?
Options:
- A. Add the option lineSep=", " to the text() function
- B. Add the option lineSep='\n' to the text() function
- C. Add the option wholetext=False to the text() function
- D. Add the option wholetext=True to the text() function
正解:D 🗳️
解説: (MogiExam メンバーにのみ表示されます)
21 of 55.
What is the behavior of the function date_sub(start, days) if a negative value is passed into the days parameter?
- A. An error message of an invalid parameter will be returned.
- B. The number of days specified will be removed from the start date.
- C. The number of days specified will be added to the start date.
- D. The same start date will be returned.
正解:C 🗳️
解説: (MogiExam メンバーにのみ表示されます)
13 of 55.
A developer needs to produce a Python dictionary using data stored in a small Parquet table, which looks like this:
region_id
region_name
10
North
12
East
14
West
The resulting Python dictionary must contain a mapping of region_id to region_name, containing the smallest 3 region_id values.
Which code fragment meets the requirements?
- A. regions_dict = regions.select("region_id", "region_name").take(3)
- B. regions_dict = dict(regions.select("region_id", "region_name").rdd.collect())
- C. regions_dict = dict(regions.take(3))
- D. regions_dict = dict(regions.orderBy("region_id").limit(3).rdd.map(lambda x: (x.region_id, x.region_name)).collect())
正解:D 🗳️
解説: (MogiExam メンバーにのみ表示されます)
5 of 55.
What is the relationship between jobs, stages, and tasks during execution in Apache Spark?
- A. A stage contains multiple jobs, and each job contains multiple tasks.
- B. A job contains multiple stages, and each stage contains multiple tasks.
- C. A job contains multiple tasks, and each task contains multiple stages.
- D. A stage contains multiple tasks, and each task contains multiple jobs.
正解:B 🗳️
解説: (MogiExam メンバーにのみ表示されます)
A developer is running Spark SQL queries and notices underutilization of resources. Executors are idle, and the number of tasks per stage is low.
What should the developer do to improve cluster utilization?
- A. Enable dynamic resource allocation to scale resources as needed
- B. Increase the size of the dataset to create more partitions
- C. Reduce the value of spark.sql.shuffle.partitions
- D. Increase the value of spark.sql.shuffle.partitions
正解:D 🗳️
解説: (MogiExam メンバーにのみ表示されます)